
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:15600222447
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

一张纸质报表、一张扫描表单,拍张照片,就能直接变成可编辑、可计算的Excel 表格。很多人以为这只是简单的拍照识字,实际上,把图片里的表格完整还原,是文档智能领域实打实的 “硬核黑科技”。
我们日常接触的传统OCR,擅长把图片里的文字抠出来,但面对表格经常 “翻车”:合并单元格直接错位,没有框线的表格变成一大段杂乱文字,多级表头彻底乱套,文字全都识别出来,行列关系却全部丢失。中科逸视(北京)科技有限公司表格识别技术,跳出单纯文字提取的思路,模拟人阅读表格的思考方式,先看懂表格骨架,再读取单元格内容,把一张静态图片,转化为真正能用的结构化数据。
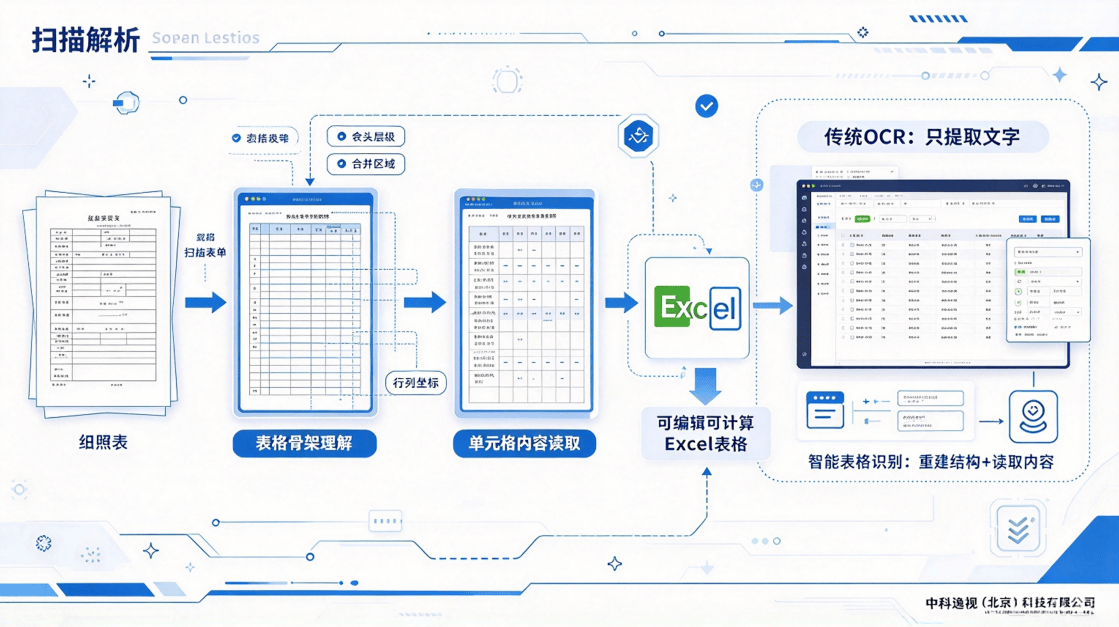
技术原理:从像素点阵,重建一整张表格的逻辑
表格识别不是某一个单一算法,而是一条完整的AI 处理流水线。整套技术融合图像增强、深度学习目标检测、像素级分割、图网络拓扑推理、OCR 文字识别、大模型语义校验多个模块,一步步把照片里的表格 “翻译” 成机器能够理解的表格结构。
第一步:图像预处理,给原始材料“修图纠错”
现实拿到的原始素材五花八门:手机随手拍摄会倾斜变形、纸张泛黄有污渍、灯光造成阴影反光、扫描件分辨率低字迹模糊。
在正式识别之前,算法会先完成图像修复。通过透视校正把歪掉的表格掰正,去除纸张噪点、优化明暗对比度,对模糊文字做增强修复,把褶皱、变形的表格图像,矫正成适合AI 解析的干净版本。这一步就好比我们看书前,先把卷边、歪斜的书页摊平,保证后面看得清楚准确。
第二步:版面定位,从一页文档中锁定表格区域
一页文件里混杂标题、段落、印章、图片、多个表格。AI 不会通篇盲目解析,而是通过深度学习检测网络,扫描整张图片,精准圈出哪些区域属于表格,哪些是普通文字段落。哪怕一页纸上嵌套好几个小表格,也可以逐个分离,避免正文文字混入表格结果当中。
第三步:结构解析,整套技术最核心的“黑科技环节”—— 重建表格骨架
认字容易,还原表格骨架才是最大难点。很多表格不全是完整实线:有的只有空白空格分隔(无线框表格),有的大量跨行跨列合并单元格,还有斜线表头、表格套表格的复杂版式,肉眼看着清晰,机器却很难分辨边界。
中科逸视表格识别在这里采用像素级分割+ 图神经网络联合推理的方案:
简单来说,这一步AI 不再只看画出来的线,而是看懂表格背后的排布逻辑,把乱糟糟的图像,重建出一套完整的虚拟网格框架。
第四步:单元格文字识别,把图像符号转为文本数字
网格框架搭建完成后,系统才对每一个小单元格单独做文字识别。针对印刷字、数字、符号、部分手写内容完成提取,区分日期、金额、编号等不同类型内容,保证每一段文字、每一组数字,精准归属到对应的行和列,不会出现内容“跑错格子” 的情况。
第五步:结构化输出,还原成可用数据
全部解析完毕,再把网格结构+ 单元格内容整合,输出 Excel、JSON 等格式,保留原本的合并单元格、层级表头,实现从图片文件到可编辑表格的完整转换。
整套流程和人阅读表格逻辑一模一样:摊平纸张→找到表格位置→看清行列布局→读取每个格子的内容,只不过 AI 在毫秒之间完成整套复杂运算。
功能特点:搞定现实世界五花八门的表格
复杂表格高保真还原
兼容低质量真实业务素材
多语种混合识别能力
多格式输出,拿来就能直接用
可快速集成落地
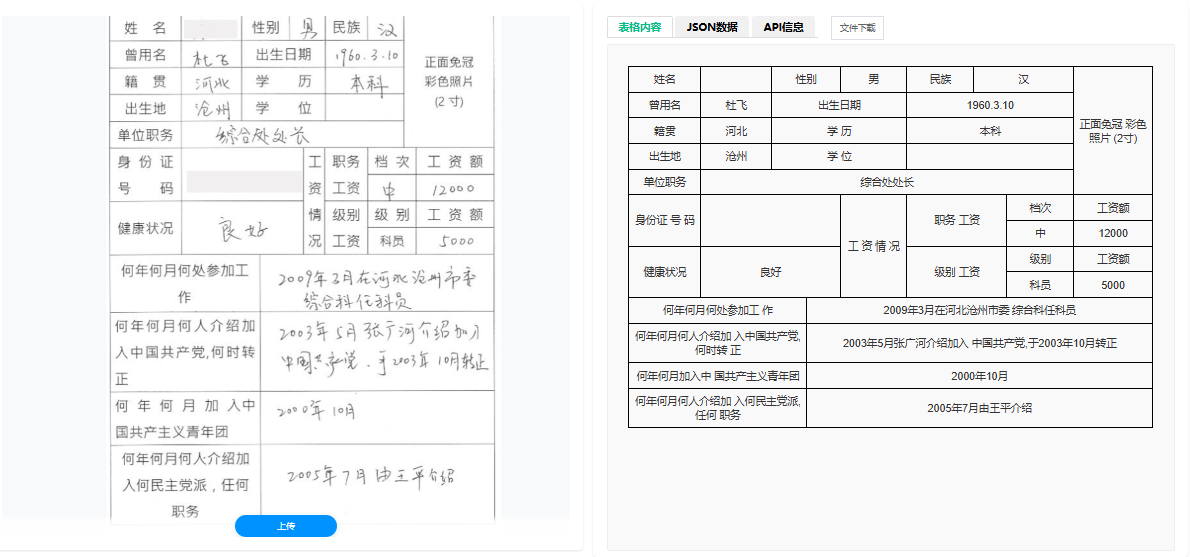
应用领域:把海量纸质表格,变成流动的数据资产
大量机构手里堆积海量纸质、扫描版表格,过去只能靠人工逐行录入,耗时耗力还容易出错。表格识别技术,就是帮各行各业把沉睡在图片、纸张里的数据释放出来。
金融与财务
政务与档案数字化
医疗健康
企业办公与科研教育
很多人以为AI 表格识别,难点在于 “认识字”。真正的门槛,是读懂看不见的逻辑。
中科逸视表格识别技术的黑科技,不在于酷炫概念,而是解决现实文档里千奇百怪的表格难题:线条不全、纸张老旧、版式五花八门。它把过去必须人工完成的表格誊录工作交给AI,让堆积如山的纸质表单,从一张张静态图片,变成可以检索、计算、流转的数据资产,实实在在降低各行各业数字化的门槛中科逸视。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2