专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:18600524535
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2
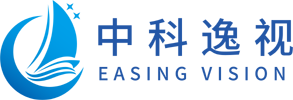
月底,财务同事桌上堆着一摞纸质报表。她打开Excel,左手压着纸,右手敲键盘,一格一格往里搬。搬完一页,抬头看一眼钟,半小时没了,眼睛也花了。
更麻烦的是,搬的过程里随时可能出错:把"1"敲成"7",把"元"漏掉,把跨了两行的合计金额填歪了一行。等到月底对账发现差了三百块钱,就得把整摞纸再翻一遍。
这类工作有一个共同的名字,叫"表格搬运"。它不需要创造力,却消耗了大量人力和耐心。而中科逸视(北京)科技有限公司做的通用表格识别技术,瞄准的正是这件事——把图片里的表格,还原成一张能算、能改、能入库的真表格。
听上去像"拍照识字"的升级版?往下看你会发现,这里面的难度,跟认字基本不是一个量级。
认字容易,认"格子"难
先澄清一个常见误解:OCR 早就成熟了,为什么表格识别还是难题?
因为文字是有形状的,表格结构是没形状的。
传统OCR 的任务,是把图片里的像素变成一串字符。它只要回答"这里写了什么"。但表格还要回答另外三个问题:
一旦这三个问题答不上来,识别出来的就是一堆散字。文字全对,表格全废——这是传统方案最常见的"翻车"方式。
更现实的问题是,真实世界里的表格根本不按模板长:
中科逸视把这一类问题总结成一句话:表格识别的门槛,不在"认识字",而在"读懂看不见的逻辑"。
他们的解法,是把整个流程拆成五步,模拟人看表格的顺序。
技术原理:AI 是怎么"看"一张表格的
把通用表格识别系统想象成一位视力极好、又特别较真的资料员。拿到一张照片,他做的第一件事不是读字,而是——
第一步:先把"拍坏的照片"修好
现实中的素材,几乎没有一张是理想的。
手机随手一拍,纸张是斜的;头顶有灯,纸面一块惨白;文件压了三年,纸边发黄、还有折痕;扫描仪老了,出来的字虚成一团。
如果直接把这些图丢给识别引擎,再聪明也没用。所以第一步是当"AI 修图师":
这一步决定了整条流水线的天花板。图修不好,后面全是白费。
第二步:在一页纸里,先找到"哪块是表格"
一页公文里,往往同时有标题、正文段落、插图、红章、页脚,还有可能塞着两三个表。
表格识别系统不会盲目通读全篇,而是先用深度学习目标检测网络扫描整张图,把表格区域圈出来,和正文段落分开。一页上有多个表,就逐个分离;表格跨了页,也能识别出这是同一条长表的延续。
这一步的价值在于"不串味"——避免正文里的文字被误塞进表格结果里。
第三步:重建表格骨架
这是核心环节,也是最"黑科技"的部分。
前面说过,很多表格的线是不完整的:虚线、断线、根本没有线。人的眼睛会自动补全这些缺失,机器不能。中科逸视的做法,是把像素级分割和图神经网络推理结合起来用。
具体怎么干:
1.找线,也"猜"线。
像素分割网络先在图上逐点判断:这里是不是一条横线,那里是不是一条竖线。碰到完全没有框线的"无线表",就换一套逻辑——根据文字的间距、行距、对齐关系,反推出那些看不见的单元格边界。
这其实很像人看东西的方式:一列数字上下对得整整齐齐,你心里自然就"脑补"出一张表格,哪怕纸上一条线都没有。
2.把格子变成"点",让算法算关系。
所有推断出的单元格,会被当成图结构里的一个个节点,然后由图神经网络(GNN)计算它们之间的邻接关系:谁在谁上面,谁在谁左边,哪些格子其实是同一个大格子被切碎了。
靠这套拓扑推理,系统能自动判断出跨行、跨列、合并单元格,还能分清哪一片是表头、哪一片是表体。它不会粗暴地把合并单元格拆散成一堆小格——这一点在财务报表里尤其重要,一个大格里写的往往是"合计"这种统管全表的信息。
3.用语义再校验一遍。
只看线条,容易犯机械错误。所以系统还会请大模型"复核":结合格子里文字的实际含义,判断结构是否合理。比如某个格子里写着"其中:应收账款",语义上它显然是个子项,结构归属就应该往下一层走,而不是和父项并列。
线条给出几何答案,语义给出业务答案,两者对齐,结构才稳。
值得一提的是,中科逸视在这套架构里做了一件关键的事:版式分析和文字识别是同步进行的。
传统方案是串行的——先把字认完,再回头猜结构,两步之间信息不互通,错误会逐级累积。而他们的做法是"边分析、边识别":识别某个字的时候,系统已经知道这个字属于哪个单元格,于是能利用周边的框线信息和上下文来提升识别准确率。就像人读表格时,眼睛和脑子是同时在线的。
底层识别引擎用的是CNN + Transformer 混合架构:CNN 负责"看形状",抓笔画、纹理、边框这些视觉特征;Transformer 负责"看全局",理解行列之间的语义对应。一个管局部,一个管整体。
第四步:逐格读字,一个都不许跑错格
骨架搭好,才开始认字。
系统对每一个单元格单独做文字识别,覆盖印刷体、数字、符号,也能处理一部分手写内容。同时会区分内容类型——这是日期、这是金额、这是编号,为后续的数据处理留好接口。
关键在于归属准确:每一段文字、每一组数字,都要精准落回它原来所在的行和列,不能"跑错格子"。前面第三步花那么大功夫重建结构,就是为了让这一步不出现错位。
第五步:结构化输出,直接能用
最后,把"结构"和"内容"合到一起,输出成 Excel、CSV、JSON、HTML 等格式。
输出的Excel 不是一张被拍平的表格——合并单元格还在,多级表头还在,行列样式还在。打开就能直接拖公式、做透视、画图表,不需要人工再调整一遍排版。
整个流程跑完,从上传图片到拿到结果,通常是毫秒级。
用一句话概括这套流程:摊平纸张→ 找到表格 → 看清行列 → 读取格子 → 输出成表。和人的阅读顺序一模一样,只是 AI 把这套动作压缩到了眨眼之间。
功能特点:专治真实世界的"疑难杂症"
结构级还原,不是只给一堆字
零模板,开箱即用
多语种混排
输出格式齐全
扛得住批量,部署也灵活
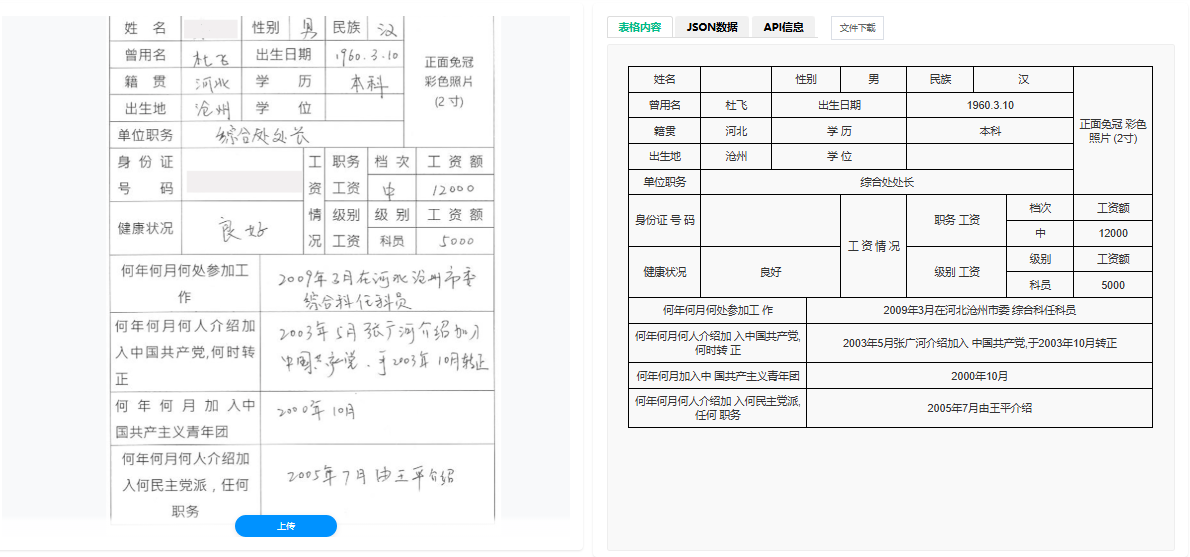
应用领域:它已经在这些地方悄悄干活了
表格是商业世界的通用语言,哪里有报表,哪里就有它的位置。
写在最后
我们平时不太会注意到这类技术,它不像人脸识别那样有存在感,也不像大模型那样天天上头条。但它做的事很实在:在纸质世界和数字系统之间,架一座桥。过去,人是这座桥上唯一的搬运工——一格一格地抄,一遍一遍地核。现在,这部分搬运交给了算法,人可以去做判断、做分析、做那些真正需要脑子的事。表格识别技术的价值,或许不在于用了多复杂的网络结构,而在于它愿意去啃那些"不体面"的难题:歪的、糊的、缺线的、盖了章的、纸张发黄的老档案。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2