
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:18600524535
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

月底,财务同事桌上堆着一摞纸质报表。她左手压着纸,右手敲键盘,一格一格往 Excel 里搬。搬完一抬头:半小时没了,眼睛也花了。更糟心的是,中途还容易把"1"敲成"7",等到对账差了三百块,又得把整摞纸翻一遍。
这类工作有个统一的名字,叫"表格搬运"。不需要创造力,专治耐心。
有人会说:现在不是有 OCR(文字识别)吗?拍张照不就转文字了?
还真没那么简单。中科逸视做的表格识别技术,瞄准的正是这个"拍照识字搞不定"的场景——把图片里的表格,还原成一张能算、能改、能入库的真表格。
先澄清一个常见误解:OCR 早就不新鲜了,为什么表格识别还是难题?
因为文字是有形状的,而表格的结构是没形状的。
传统 OCR 的任务,是回答"这里写了什么"。但表格还要回答另外三个问题:
这三个问题答不上来,识别出来的就是一堆散字——文字全对,表格全废,这是传统方案最常见的翻车方式。
更麻烦的是,真实世界里的表格根本不按模板长:有的没框线,全靠空格对齐;有的大格子里套着四行小字;有的表头带斜线;有的表跨了两页还没完,甚至表格里还套着表格。
我们把这类问题的门槛总结成一句话:表格识别难,不在"认识字",而在"读懂看不见的逻辑"。
可以把这套系统想象成一位视力极好、又特别较真的资料员。拿到一张照片,他的动作分五步,和人看表格的顺序几乎一样。
第一步:先把"拍坏的照片"修好
现实中的素材几乎没有一张是理想的:手机随手拍是歪的,头顶有灯光斑惨白,档案纸发黄有折痕,扫描件字虚成一团。直接丢给识别引擎,再聪明也没用。
所以第一步是当"AI 修图师":
这一步决定了整条流水线的天花板——图修不好,后面全是白费。
第二步:先找到"哪块是表格"
一页公文里往往混着标题、正文、插图、红章,甚至好几个表。系统不会盲目通读全篇,而是用深度学习目标检测网络扫描整张图,把表格区域一个个圈出来,和正文段落分开。一页多个表就逐个分离,表格跨页也能认出"这是同一条长表的延续"。
这一步的价值是"不串味"——避免正文文字被误塞进表格结果里。
第三步:重建表格骨架
很多表格的线是不完整的:虚线、断线、根本没有线。人的眼睛会自动脑补,机器怎么办?
中科逸视的做法是像素级分割 + 图神经网络(GNN)联合推理:
还有一个细节值得说:版式分析和文字识别是同步进行的。传统方案是先认字再猜结构,两步信息不互通,错误会逐级累积。而表格识别的方案是"边分析、边识别"——识别某个字时,系统已经知道它属于哪个单元格,能利用周边框线和上下文反过来提升识别准确率。就像人读表格时,眼睛和脑子是同时在线的。
底层识别引擎用的是 CNN + Transformer 混合架构:CNN 负责"看形状",抓笔画、边框这些视觉特征;Transformer 负责"看全局",理解行列之间的语义对应。一个管局部,一个管整体。
第四步:逐格读字,一个都不许跑错格
骨架搭好才开始认字。系统对每个单元格单独识别,覆盖印刷体、数字、符号,也能处理一部分手写内容,并区分日期、金额、编号等内容类型。
关键是归属准确:每段文字都要精准落回原来的行和列。前面第三步费那么大劲重建结构,就是为了这一步不错位。
第五步:结构化输出,直接能用
最后把"结构"和"内容"合体,输出 Excel、CSV、JSON、HTML 等格式。输出的 Excel 不是被拍平的表格——合并单元格还在,多级表头还在。打开就能直接拖公式、做透视、画图表。
整套流程跑完,从上传到出结果通常是毫秒级。一句话概括:摊平纸张 → 找到表格 → 看清行列 → 读取格子 → 输出成表,和人读表格的顺序一模一样,只是 AI 把这套动作压缩到了眨眼之间。
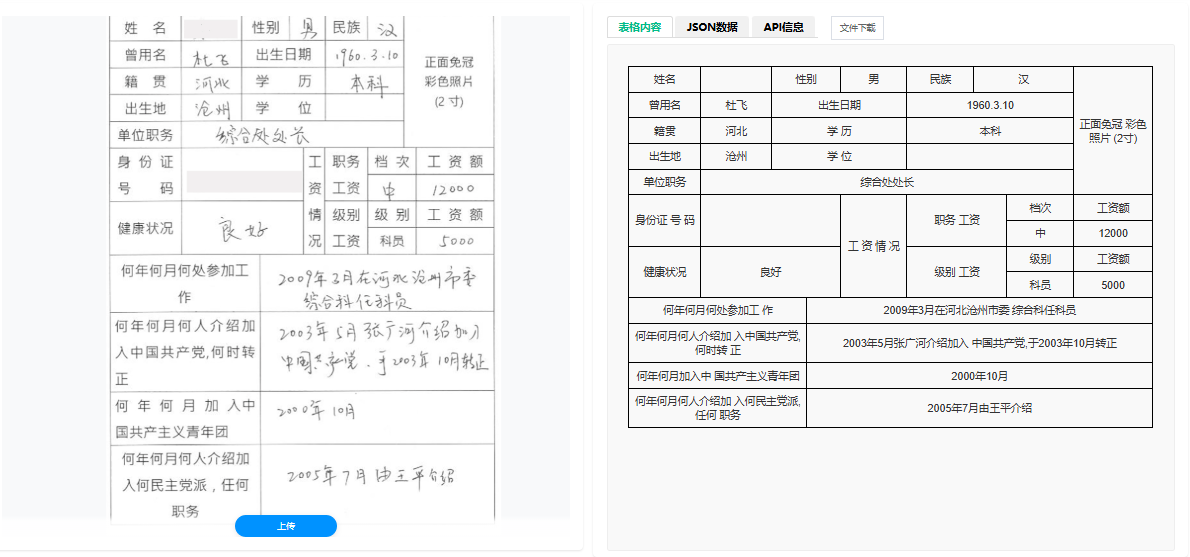
表格是商业世界的通用语言,哪里有报表,哪里就有它的位置。
我们平时不太会注意到这类技术。它不像人脸识别那样有存在感,也不像大模型那样天天上头条。但它做的事很实在:在纸质世界和数字系统之间,架一座桥。
过去,人是这座桥上唯一的搬运工——一格一格地抄,一遍一遍地核。现在,这部分搬运交给了算法,人可以去做判断、做分析,做那些真正需要脑子的事。
表格识别技术的价值,或许不在于用了多复杂的网络结构,而在于它愿意去啃那些"不体面"的难题:歪的、糊的、缺线的、盖了章的、纸张发黄的老档案。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2