
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:18600524535
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

先做个小测试:打开手机里任意一个银行应用,点"添加银行卡",然后手动敲那 16 位数字。敲到第 12 位,微信响了,你抬头看一眼,再低头——完了,数到哪儿了?
重来。这次小心一点,敲完数一遍,怕漏;再数一遍,怕错。一张卡,两分钟。
这事儿的荒诞之处在这儿:一串数字,人抄起来又慢又容易错,机器却只要看一眼。而"看一眼"这三个字,背后是二十多年图像处理和一整代深度学习的积累。
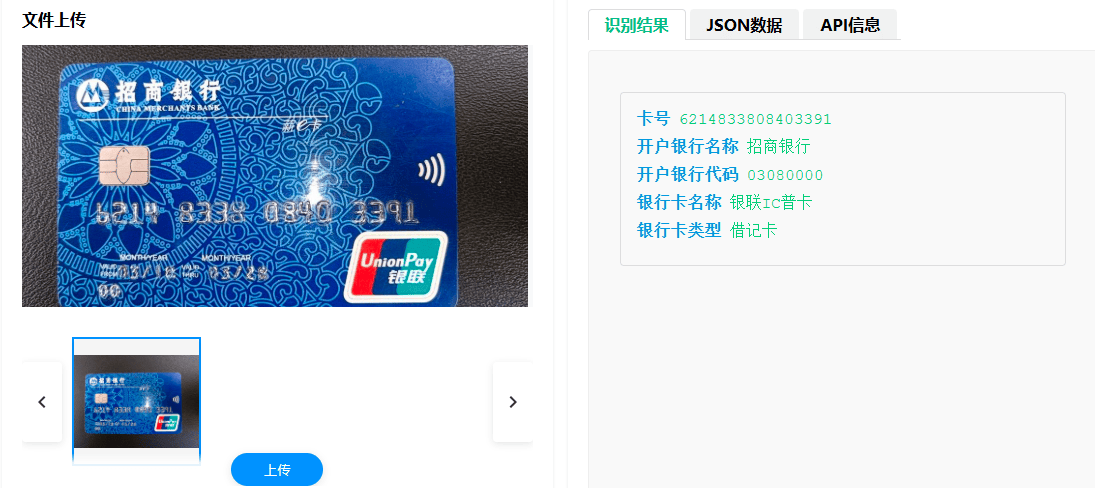
中科逸视的银行卡识别技术,就是“拍照读卡”的流水线。它本质上是OCR(光学字符识别)在金融场景里的一次“专项训练”,只不过银行卡是一块出了名难啃的骨头:反光、倾斜、凹凸不平的凸字,普通OCR碰到这些情况经常直接“翻车”。
"光学字符识别"这词听着专业,说白了就是让机器认字。它在扫描件上早就干得很好了:白底黑字,端端正正躺着,认一百遍错不了一遍。
可银行卡完全是另一个路数。它身上叠了好几层不利条件:
所以结论有点反直觉:银行卡识别的难点不在"认数字",而在让一堆数字在很糟糕的条件下,依然被稳稳地认对。
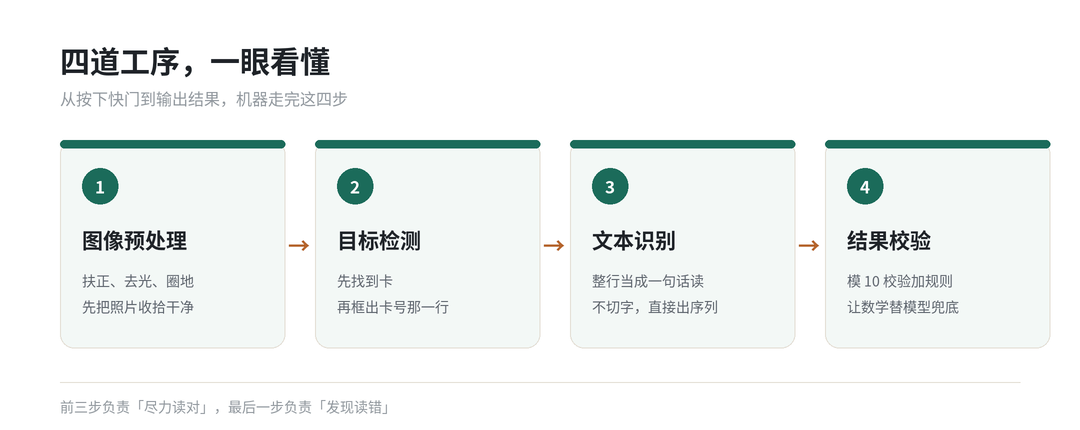
中科逸视银行卡识别系统的解法,是把深度学习和传统图像处理缝在一起,串成一条闭环流水线:
图像预处理 → 目标检测 → 文本识别 → 结果校验
工序一:先给照片"收拾干净"
你随手拍的图,机器直接吃下去是要闹肚子的。所以第一步是预处理,干三件事:扶正、去光、圈地。
工序二:先找到卡,再找到那一行数字
定位分两级,都用深度学习模型。
第一级,找卡。 用一类专门"在杂乱画面里找目标"的检测模型。注意,输入往往不是一张干净的卡片特写,而是一整张图——卡的旁边可能有桌面、有手指、有半杯咖啡、有快递盒。模型要在这一堆杂物里把卡面框出来、裁出来,只留下卡。
第二级,找卡号行。 用一类专门找文本行的检测模型,在卡面上框出卡号所在的那一条横带。这里有个关键设计:它们预测的是文本行的外框,不是单个字符的位置。
这一步等于把工序一里提到的"切字"难题绕开了。模型不需要知道第 7 个数字从哪个像素开始、到哪个像素结束,它只需要知道"这一条是卡号"。切字的活儿,交给下一步。
顺便说,要适配的版式比想象中多:横版、竖版、卡号位置有偏移的、卡面图案复杂到底纹和数字打架的。所以训练集里得有足够多的"不标准",模型才不会只认标准件。
工序三:把一整行,当成一句话来读
这是整套技术的核心,用的是"卷积神经网络 + 循环神经网络"的组合架构,最后再配一套时序对齐机制收尾。拆开看,三个角色各管一摊。
为什么这套比"切字再认字"强?因为切字那一步最容易崩,而且崩了没救。这套结构压根不切,它输出的是一整个序列,模型在训练中学会的是"一串卡号大概长什么样"。某个字符糊了,它靠前后文推断;字体怪了,它见过类似的。
模型聪明不聪明,全看喂了什么。训练样本要覆盖不同银行、不同材质(塑料、金属、透明)、不同工艺(凸印、平面印刷、激光雕刻)、不同程度的磨损——样本够杂,模型才不会变成"只认崭新卡片"的娇气包。
最后是工程上的收尾:把模型剪枝、量化,体积和运算量一起压下来。结果是单张识别 100 毫秒以内,准确率 98% 以上。100 毫秒是什么概念?你眨一次眼大约 300 毫秒,它能在你眨眼的过程中把卡读完三遍。
工序四:让数学替模型兜底
模型会犯错,98% 的准确率意味着每一百次里有两次看走眼。在别的场景里这叫"可以接受",在金融场景里这叫"事故"。
所以系统不直接相信模型,它还要过三道关:
三道关都过了才输出;过不了的,要么让人复核,要么请用户重拍一张。
有意思的地方在这儿:这套校验规则的存在,让"准确率"这个指标不再是玄学。识别加校验的组合,比单看模型准确率要靠谱得多——模型负责"尽力读对",数学负责"发现读错"。
识别率、响应速度是入场券,真正决定能不能落地的是这些:
银行卡识别属于那种"用了没感觉、没了很难受"的技术,你大概已经在好几个地方跟它打过照面:
回到开头那个场景。你今天少打了 16 个数字,可能只是觉得"这个应用还挺顺手"。
但这背后是一群人花了很多年,研究怎么让机器在一片反光里看清一个"8":怎么把歪掉的梯形拉正,怎么让模型不靠切字也能读完整串,怎么用一个六十年前发明的校验规则,给一个概率模型加上确定性的护栏。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2