
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:15600222447
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

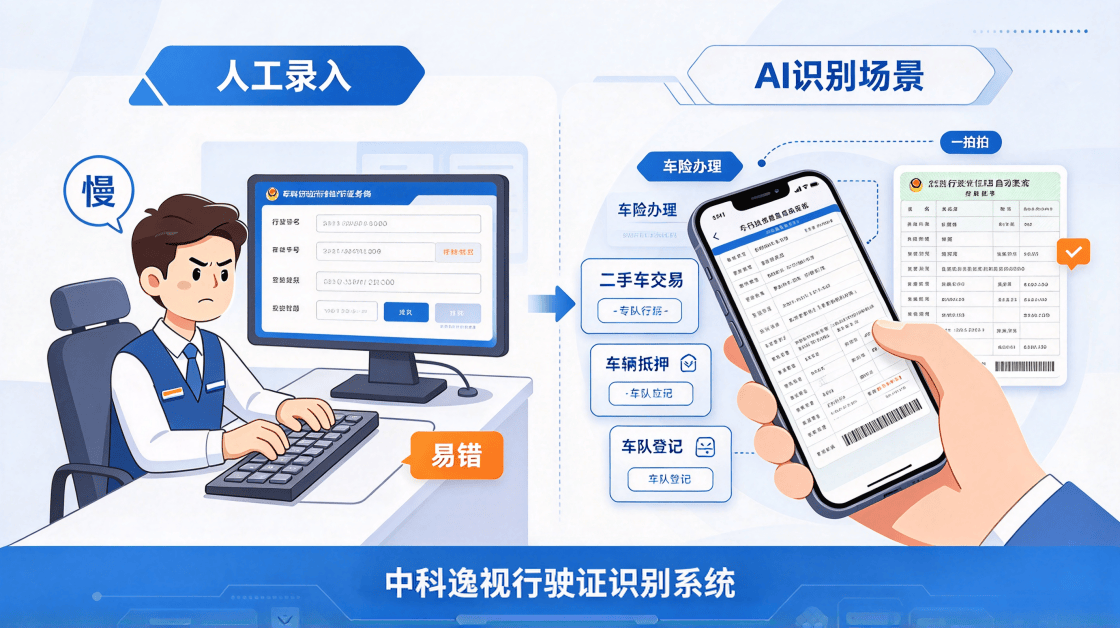
一张小小的行驶证,相当于汽车的“身份证”,车牌、车主信息、VIN 车辆码、发动机号、年检有效期、使用性质等几十项关键信息全部记录其上中科逸视。过去办理车险、二手车交易、车辆抵押、车队登记,都要人工对着证件一字一字录入,不仅慢,手敲错数字、看错字母的情况时常发生。
随着AI 视觉技术成熟,拍照识别行驶证已经走进各行各业。中科逸视(北京)科技有限公司自研行驶证识别技术,不只是简单的图片转文字,而是一套计算机视觉 CV + 自然语言处理 NLP 协同工作的完整智能系统,手机随手一拍,就能把纸质行驶证的全部信息,直接转化成可直接导入业务系统的结构化数据。
很多人以为OCR 就是 “扫描拍照识字”,但现实中手机随手拍的照片会反光、歪掉、折角、光线昏暗,普通识别工具很容易读错 VIN 码、发动机号这类复杂混合字符。行驶证识别的 “黑科技”,恰恰就体现在处理这些真实世界的麻烦。
技术原理:从模糊照片到可用数据的完整五重链路
整套技术可以通俗理解成:先给照片“修图治病”,再找到每一块信息位置,看懂文字,再用业务逻辑做校验纠错,最后输出整齐规范的数据,一共分为五大环节,环环相扣。
1.图像预处理:给“拍坏” 的证件做智能修复
手机拍摄的原始图片经常出现歪斜、透视变形、反光阴影、褶皱、背景杂乱。系统第一步不会直接识别文字,而是先对图像做修复:
经过这一步,哪怕拍摄质量一般的照片,也变成适合AI 阅读的干净图像。
2.版面目标检测:精准定位每一块信息的位置
行驶证有固定版式,但正页、副页字段排布复杂,VIN 码、发动机号、车主姓名分布在不同区域。
这里依靠深度学习目标检测模型,不是整张图笼统扫一遍,而是像人眼一样,分别标记出号牌号码、所有人、品牌型号、VIN 码、发动机号、注册日期、检验有效期等每一个字段的具体位置,框选出每一小块需要识别的区域。
区别于传统模板匹配:老模板算法只能适配固定角度的证件,一旦证件稍微偏移就失效;深度学习检测可以适应角度偏移、轻微折损,精准锁定每一个信息块。
3.深度学习字符识别:读懂汉字、数字、混合编码
定位完成后,把各个小块区域送入专用字符识别模型。
行驶证存在大量字母+ 数字混合字段,典型就是 17 位 VIN 车辆识别代号、发动机号,字符极易混淆(数字 0 和字母 O、数字 1 和字母 I)。
中科逸视针对行驶证专用数据集完成模型训练,专门优化这类易混淆字符识别,区分印刷字体细节,把图片上像素笔画转化为原始文本字符串。
到这一步,系统已经读出图片上所有文字,但此时文本还是一堆零散文字碎片,机器还不懂“哪段文字对应哪个信息”。
4、NLP 语义解析:看懂文字背后的业务含义
普通OCR 到此就输出原始文本,结果杂乱无序,还需要人工再整理。而这套系统加入 NLP 自然语言处理能力,完成语义理解:
简单说:不只是“看见字”,而是理解这行字代表什么业务信息。
5.业务规则逻辑校验:自动排错,降低识别失误
这是保障落地可用性的重要一环。系统内置车辆证件业务规则引擎,对识别结果做合理性检查:
经过校验过滤,最终输出标准化JSON 结构化数据,车牌、VIN、车主、年检时间等字段一一对应,可以直接对接业务系统,无需人工二次抄写。
总结技术链路:图像修复矫正→ 字段区域精准定位 → 深度学习字符读取 → NLP 语义归类理解 → 业务逻辑校验纠错 → 结构化数据输出
功能特点:贴合真实业务场景的能力
全字段识别,正副页兼容
恶劣拍摄环境高鲁棒性
多版本版式兼容
输出结构化数据,可直接对接系统
置信度输出,风险可复核
支持多部署形态
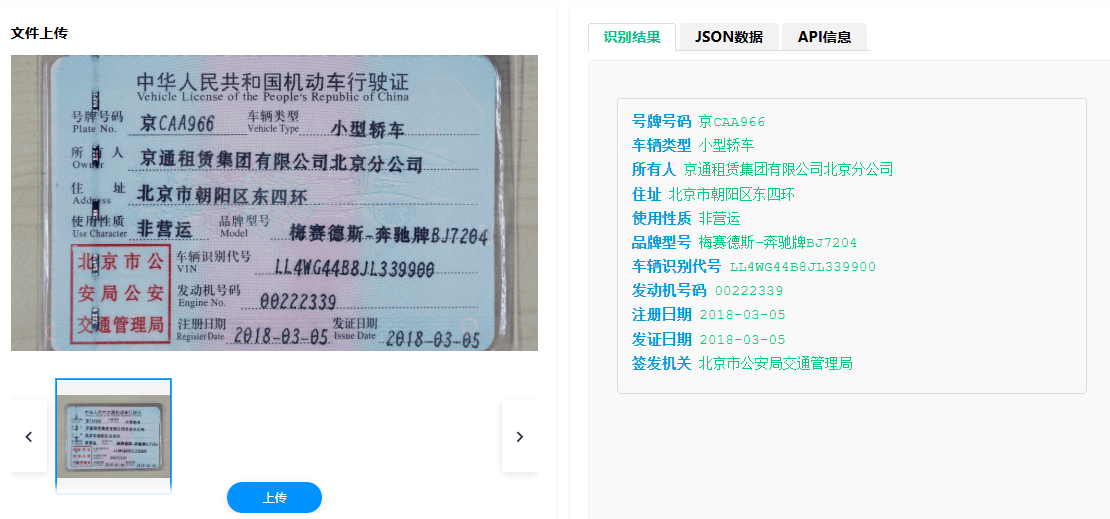
应用领域,哪些行业在使用行驶证识别?
保险行业:车险投保、查勘定损
汽车金融、二手车交易、车辆抵押
智慧出行:网约车、租车、货运平台
政务与企事业单位车队管理
行驶证识别看起来只是一个“拍照识字” 功能,但真正落地产业,难点恰恰是应对现实世界五花八门的拍摄条件、磨损证件。中科逸视行驶证识别技术,跳出传统简单 OCR 的局限,把机器视觉和语义理解结合起来,让 AI 不止看懂图片里的笔画,更读懂证件背后的车辆业务信息,为交通相关行业数字化,提供底层的 AI 能力底座。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2