
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:15600222447
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

日常工作里,报表、检测单、档案表单无处不在。大量有价值的数据,被锁在纸质纸张、扫描图片、手机照片里。普通OCR只能把图片变成一堆散乱文字,行列错位、合并单元格丢失,拿到的文本根本没法直接统计、计算,还需要人手工重新整理录入。
中科逸视(北京)科技有限公司表格识别技术,跳出单纯“认字”的局限,让机器既能看懂文字内容,又能读懂表格的网格骨架,把一张图片表格,直接还原成可编辑、可分析的Excel、结构化数据,解决海量表格人工录入的痛点。
很多人以为表格识别就是高级拍照识字,实际上它是计算机视觉+深度学习+语义理解三者结合的综合技术,难点不在识别文字,而在看懂表格的“逻辑结构”。
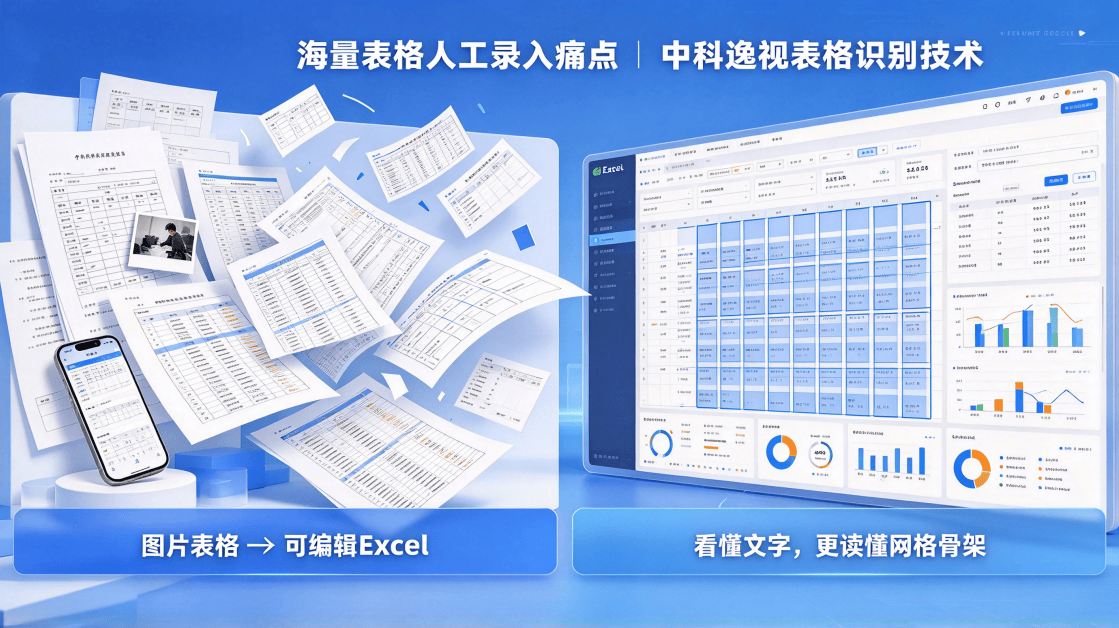
普通人看表格,是先看整体边框、分清几行几列,再读每个格子里面的文字。中科逸视表格识别,就是模仿人的阅读逻辑,分成完整的技术链路,一步步完成从像素图片到结构化表格的转换。
1、图像预处理:把“烂图片”修好
现实拿到的原始素材并不完美:手机随手拍会倾斜变形、扫描件泛黄模糊、光照不均有阴影、纸张褶皱、边框断线。 系统首先做图像修复:自动矫正倾斜透视、去除噪点阴影、增强文字对比度、修复断裂表格线条。哪怕是质量一般的档案老扫描件,也先把图片质量拉到适合算法解析的水平,为后面识别打好基础。
2、表格区域定位:从文档里揪出表格
一份文档里面混杂文字、图片、多张表格。算法通过深度学习目标检测模型,快速扫描整张文档,精准锁定哪些区域属于表格,哪些是普通段落文字,把表格区块单独截取出来,避免正文文字干扰表格解析流程。
3、像素级结构重建:还原表格的骨架
这是整套技术最硬核的一步,也是和普通OCR最大的区别。 很多表格没有实线边框,只有靠文字对齐形成的隐形网格;还有合并单元格、斜线表头、多级表头、嵌套子表格、一张表格跨两页等复杂情况。
中科逸视采用语义分割+图神经网络联合推理:
简单理解:就像给破碎拼图自动拼好网格,哪怕部分边框看不见,AI也能推理出原本表格长什么样。
4、单元格文字识别+语义纠错
网格划分完成之后,再对每一个小单元格做文字识别,输出格子内的内容。 这里不只是简单识别字符,还加入上下文语义校验:把容易混淆的0和O、数字1和字母l,结合表格业务逻辑自动纠错。比如金额、日期、检测指标这类字段,会根据相邻单元格内容做合理性校验,降低识别错误率。
5、结构化输出,完成数据落地
最后把“网格位置”和“每个格子的文字内容”一一对应映射,保留原始表格全部逻辑,输出Excel、JSON、CSV等多种格式。输出结果直接用于业务系统入库、统计分析,不用人工重新排版调整。
总结整条链路:修复图片→找到表格位置→重建行列单元格骨架→识别每个格子文字并纠错→输出可用电子表格。
不同于通用工具,中科逸视表格识别面向真实业务场景打磨,解决大量现实文档的棘手问题:
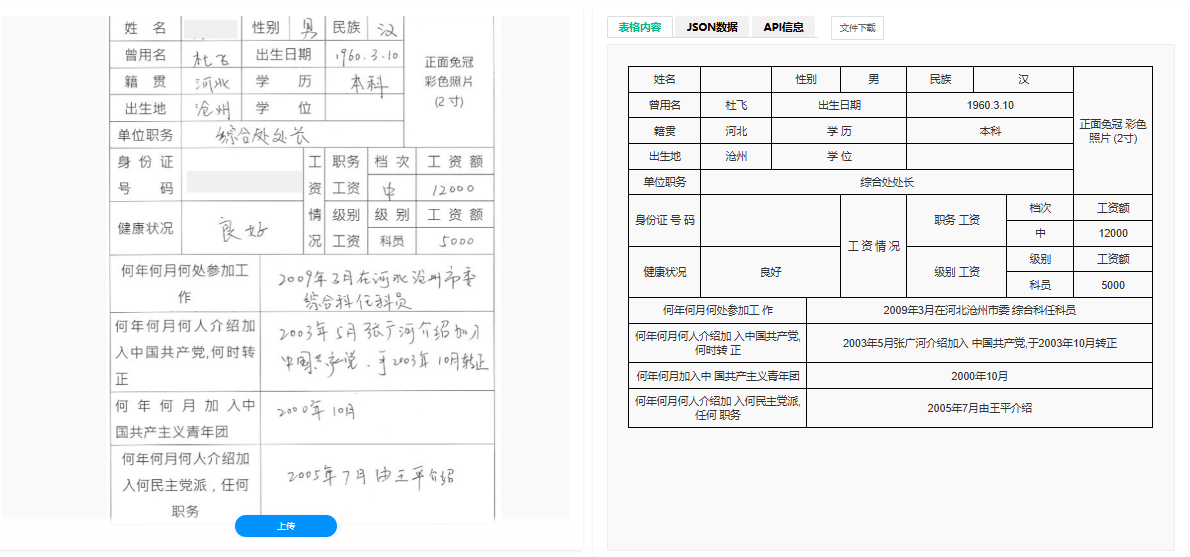
表格识别的价值,就是把沉睡在纸质、图片中的数据释放出来,广泛落地在政务、金融医疗、企业办公、档案数字化等场景。
很多人以为AI识别就是“扫一扫转文字”,但中科逸视表格识别证明,真正好用的文档AI,核心不是单纯认出字,而是读懂文档背后的逻辑关系。
无数报表、档案、报告单里藏着大量数据资产,过去只能依靠人工一点点敲进电脑。依靠表格识别技术,图片表格不再只是一张图片,而是真正可以被计算机读取、统计、分析流动起来的数据,这也是AI落地千行百业数字化很接地气的一环。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2