
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:18600524535
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

二手车行的柜台前,销售一手举着客户的行驶证,一手在键盘上戳。
戳到“车辆识别代号”那一栏就卡住了——17 位字母和数字挤成一串,念都念不顺,更别说敲。好不容易敲完,回头核对,第 7 位的“8”打成了“B”。
这类返工每天都在发生。行驶证巴掌大一张,正页副页加起来几十个字段:号牌号码、车辆类型、所有人、住址、使用性质、品牌型号、车辆识别代号、发动机号码、注册日期、发证日期;副页还有档案编号、核定载人数、总质量、整备质量、外廓尺寸、检验记录……
人工抄一遍,准确率很大程度上取决于抄的人当天睡没睡好。
所以“拍张照自动填表”这件事,听着简单,做起来一点都不简单。中科逸视的就是这样一套东西——行驶证识别系统:把一张手机随手拍的行驶证,变成能直接进数据库的字段。
下面拆开讲讲,它到底在忙什么。
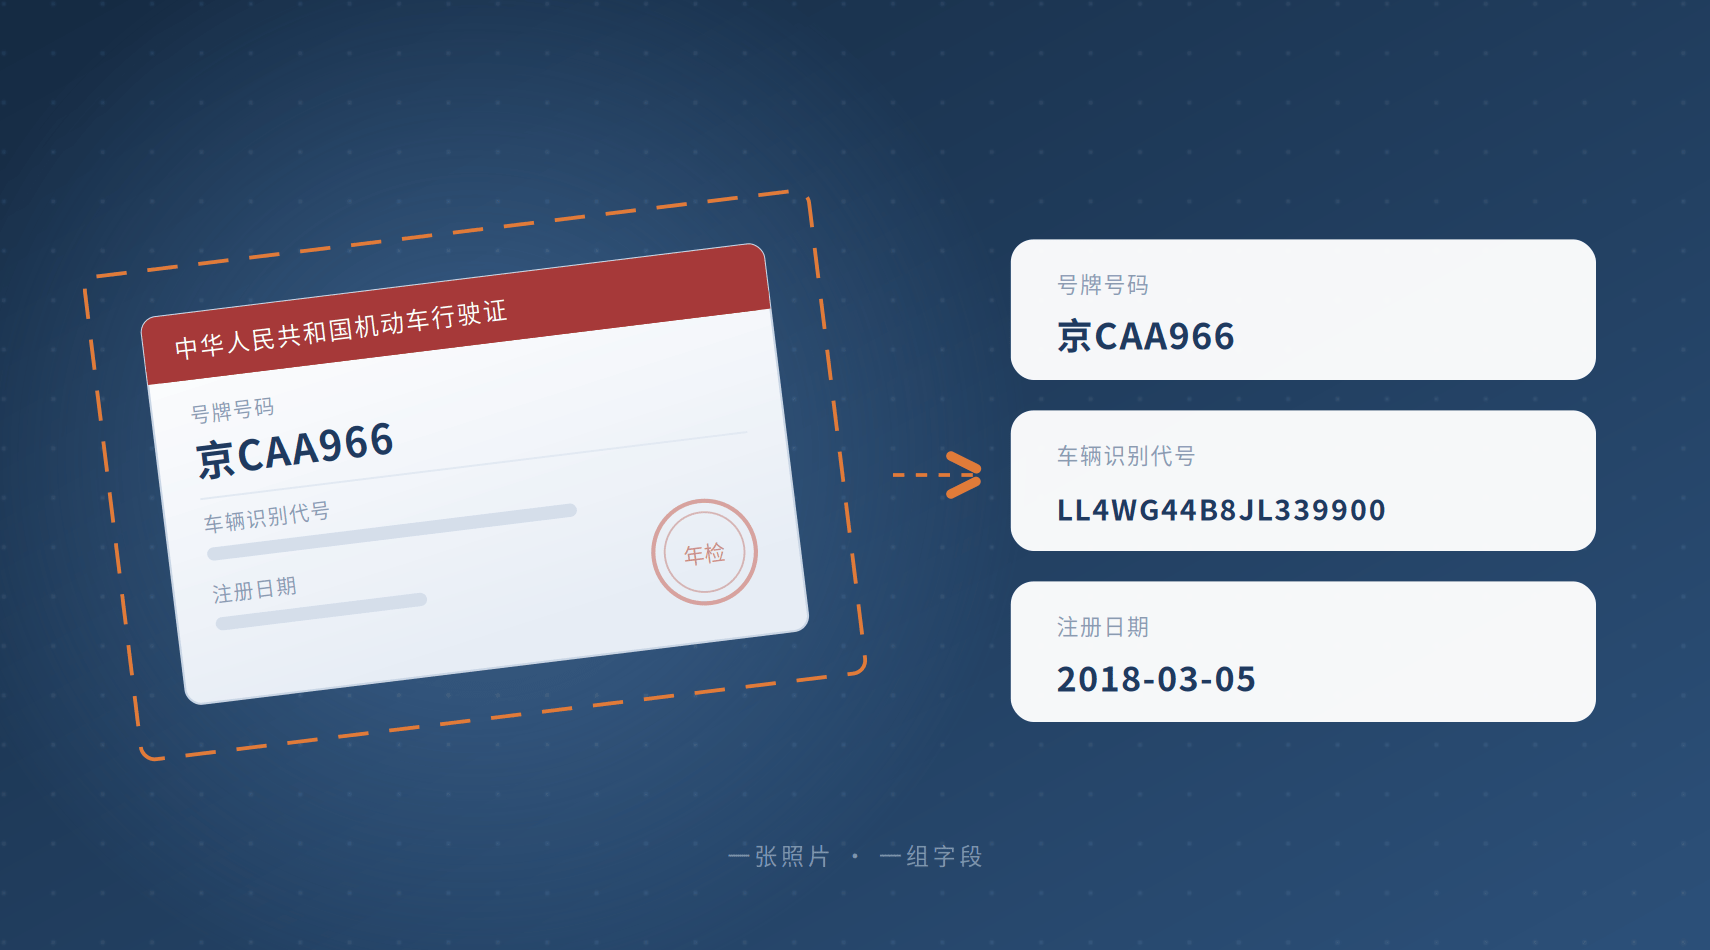
很多人对 OCR 的印象还停留在扫描仪时代:纸放平、光打匀、字印得规规矩矩,机器一扫就出字。
现实里的照片不长这样。三个麻烦绕不过去:
再叠加折痕、污渍、红章压字,以及一张堆满杂物的办公桌当背景。
一句话:不是机器不认字,是照片太不体面。
整套流程可以理解成一条流水线,每一段都在替下一段“擦屁股”。
第一段:先把图治好
系统拿到照片,不急着认字,先修图。
这一步做完,一张“手机随手拍”才勉强够格当“扫描件”用。相当于给证件做了一次正骨加医美。
第二段:找到每一块信息在哪
行驶证是固定版式,但字段排得密,正页副页还不一样。
老办法是模板匹配:预先存一张标准版式的图,拿它去照片上“对位置”。问题是一旦证件偏一点、折一下、版本换一代,模板就废了。
现在用的是深度学习目标检测。模型不整张图乱扫,而是像人眼一样,先把“号牌号码”“所有人”“车辆识别代号”“发动机号码”“注册日期”这些字段一块块框出来,输出每个框的坐标。同时判断这是正页还是副页——这一步很关键,正副页都有“号牌号码”,搞混了后面全乱。
难点在红章。签发机关的印章经常压在文字上,模型得把文字区域和印章笔画分开,不然识别出来就是一团墨。
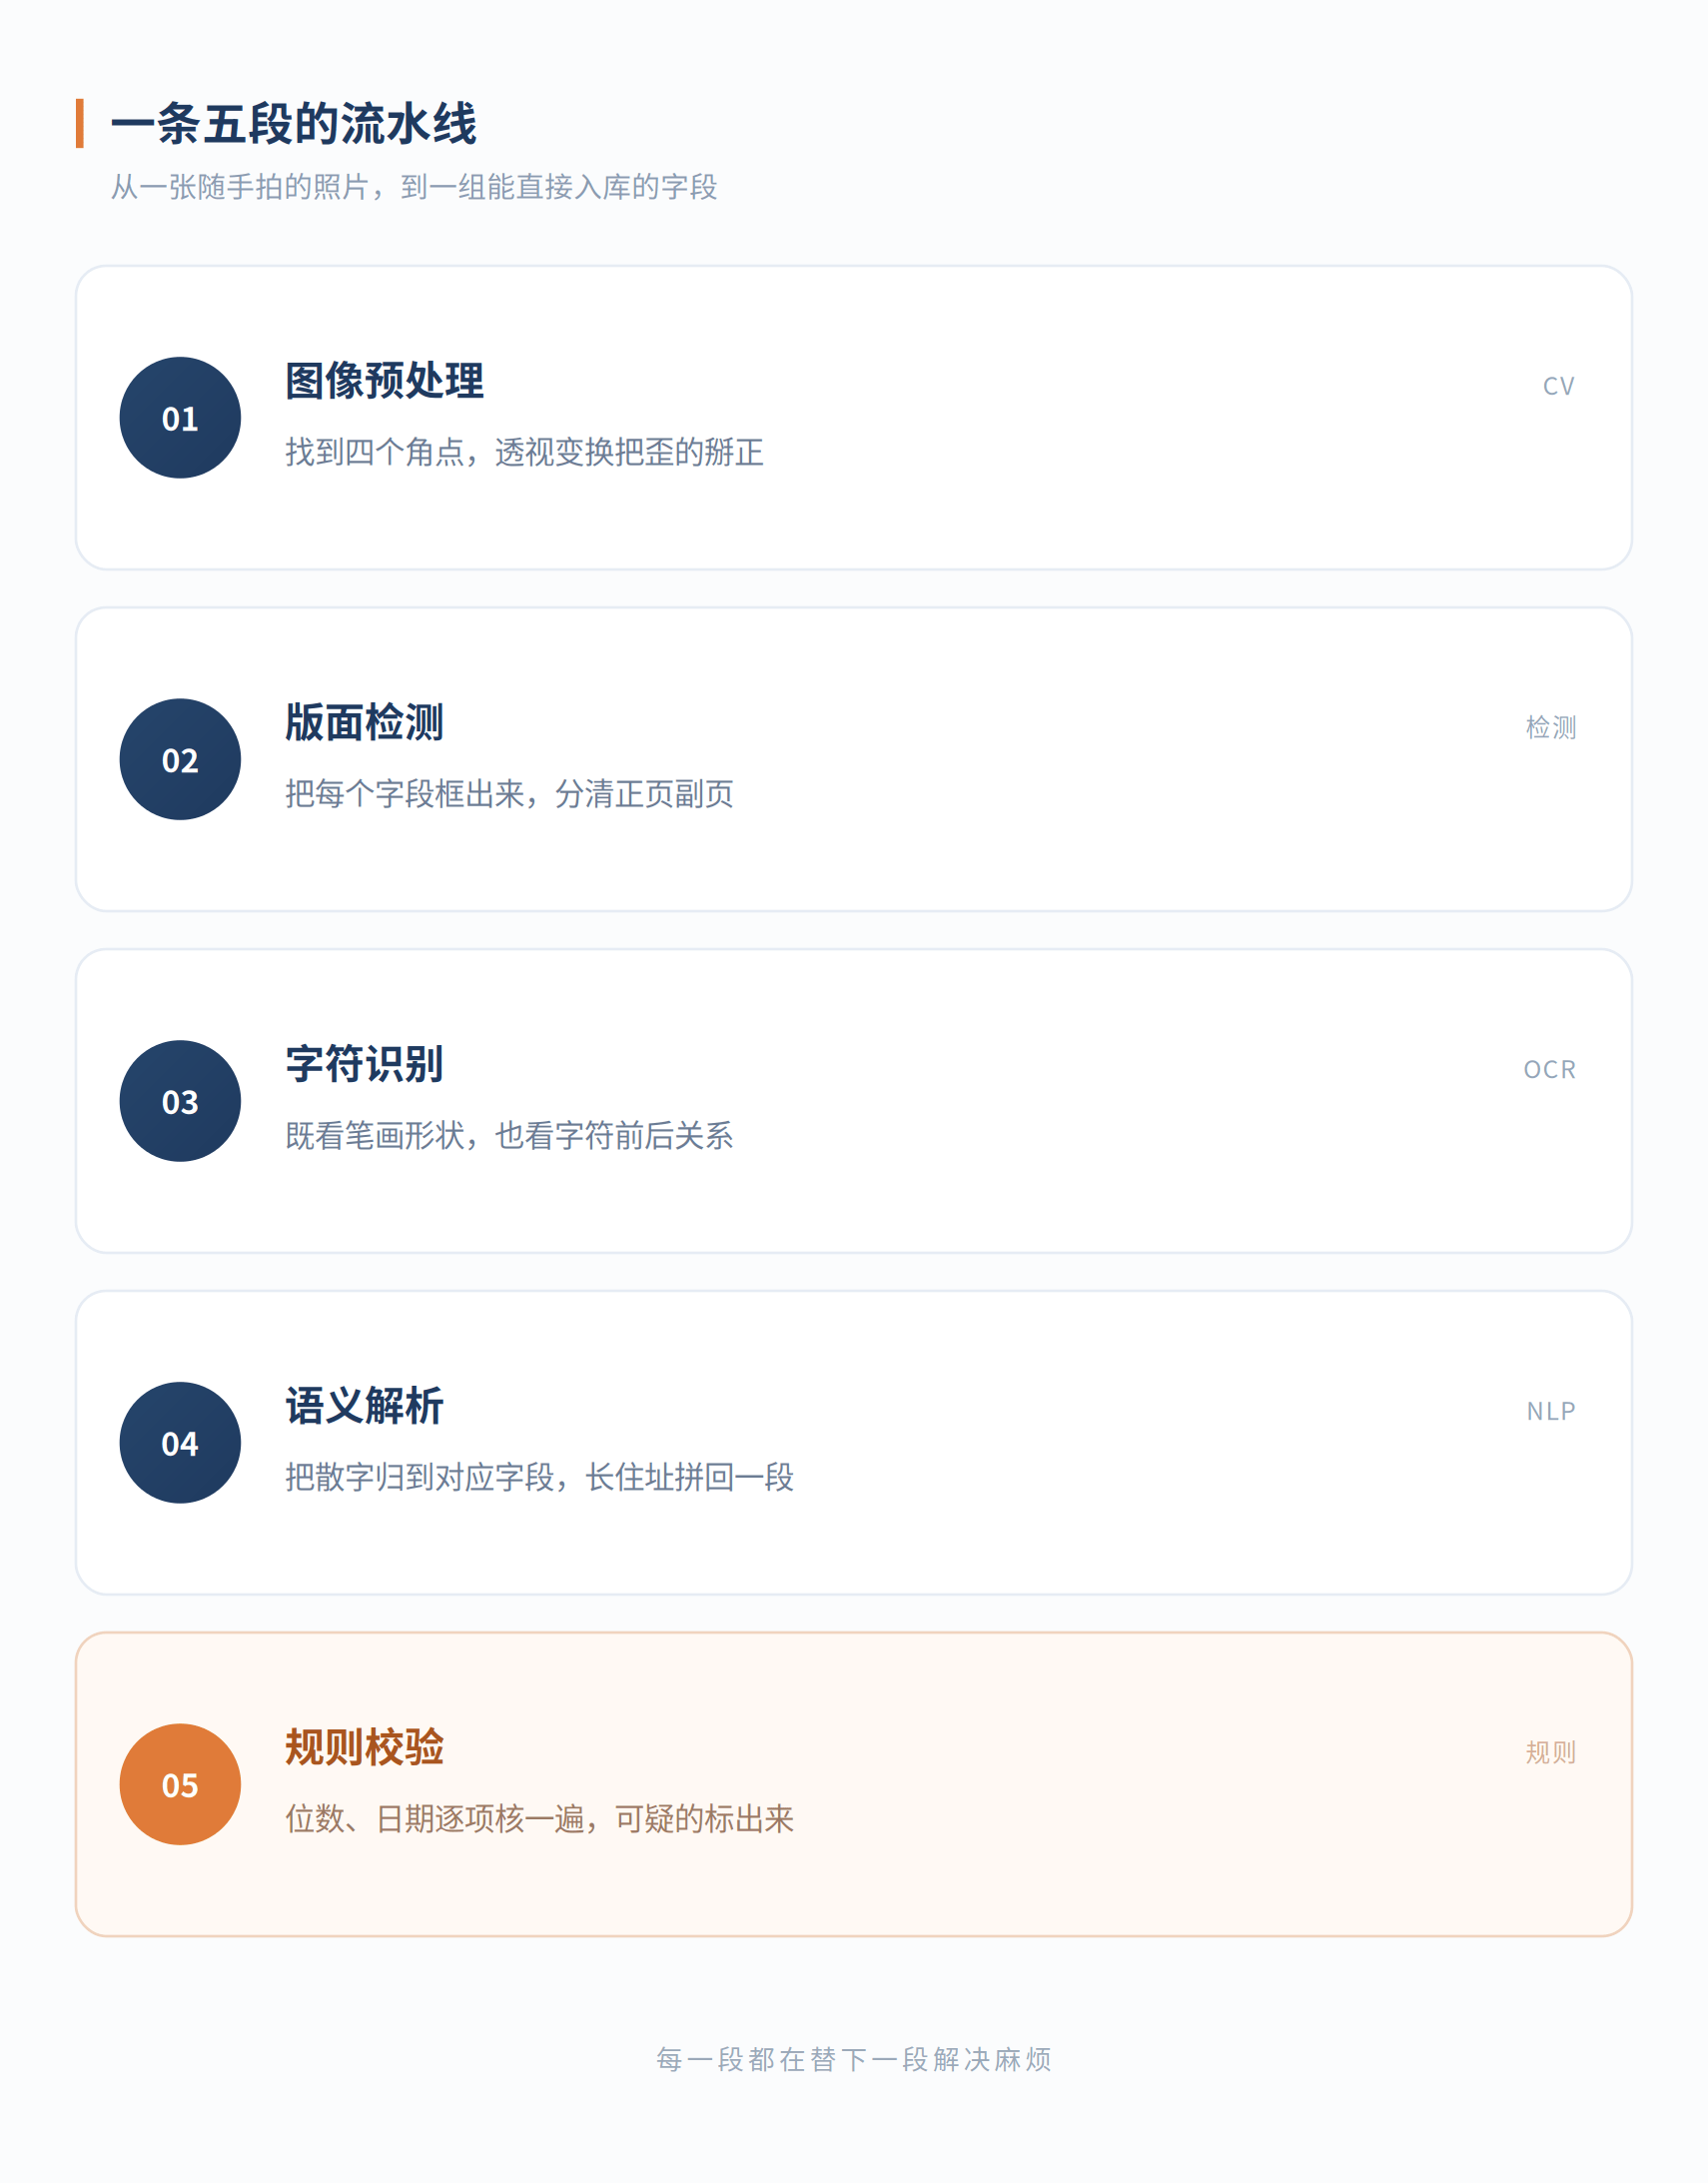
第三段:认字,重点在“长得像”
框出来了,接下来才是传统意义上的 OCR。但现在的做法,和“一个字一个字切开来认”已经不一样了。
主流方案是 CRNN 加 CTC:卷积层负责看笔画的形状、粗细、纹理;循环层负责看这一串字符的前后关系;CTC 负责解决“图片宽度和字符数量对不上”的对齐问题。
前后关系为什么重要?因为单个“0”和“O”确实难分,但把它放回“BJ7204”这种上下文里,机器就有了语感。就像你看到“京CAA966”,不会怀疑那个 0 是字母 O。
针对行驶证,还有几处专项优化:
说白了,AI 不是天生会认字,是被几百万张歪的、糊的、反光的照片一点点喂出来的。
第四段:读懂这行字该填哪个格子
认出来的是一堆散落的文本,机器还不知道“这段是车主住址”还是“这段是发证机关”。
这一步交给自然语言处理:实体抽取、字段映射,把零散文字归到预设字段上。住址经常很长、跨行、中间夹着省市区,需要按语义拼回去;检验记录是一串日期,要拆成一条条记录。
做完这步,输出的就不再是“一段文字”,而是“一组字段”。
第五段:自己给自己挑错
这是最容易被忽略、但决定能不能真用的一步。
系统内置一套业务规则,对结果做合理性检查:
到这儿,最终产物是一份 JSON:车牌、VIN、车主、注册日期、检验有效期,一项对一项。业务系统直接拿去入库,不用人再抄一遍。
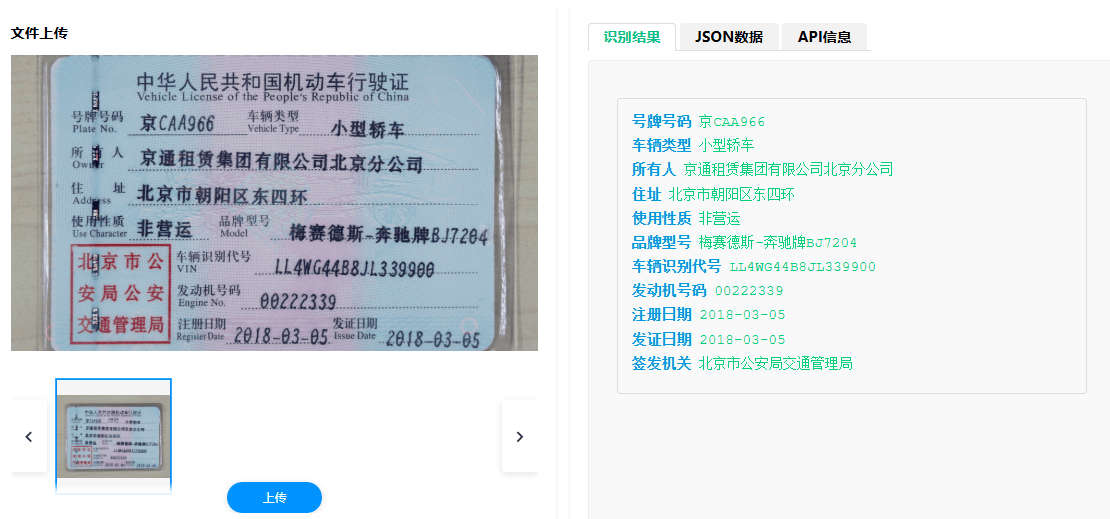
行驶证识别听起来像个不起眼的小功能,但它面对的是现实世界最难缠的部分:人会拍歪、会手抖、会把证件塞在钱包里磨出折痕。
技术做得好的标志,往往不是“多厉害”,而是“多没存在感”——用户拍一下,信息就填好了,谁也不会去想背后跑了几个模型。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2